

사이트맵이 안읽힌다
일단 https://nirobase.me/ 에 대한 사이트맵 https://nirobase.me/sitemap-index.xml 을 제출한지도 세 달이 지났다. Google Search Console 에선 분명히 상태가 ‘성공’ 으로 나오는데 발견된 페이지는 여전히 0개, 발견된 동영상 0개로 나왔다.
‘sitemap-index.xml 이라서 실제 바로 사이트 맵을 그리는 형태가 아니라서 이렇게 표시되는건가’ 하고 넘어갔었지만 아무리봐도 느낌이 이상했다.
점검을 해보았다. 아무래도 문제가 맞다. 0개로 나오면 안되는 것이다…
URL 검사를 활용
GSC 에서 URL 검사 (실제 URL 테스트) 를 sitemap-index.xml 에 실행했는데 문제 없이 가져와졌다.
그러나, sitemap-0.xml 에 대해서 실행했을 땐 못가져왔다. 도대체 왤까.
robots.txt
결과 메세지는 실패 : robots.txt 에 의해 차단됨. 범인은 바로 내가 작성한 robots.txt 였다.
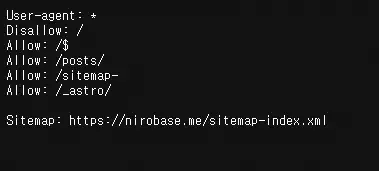
User-agent: *Disallow: /Allow: /$Allow: /posts/
Sitemap: https://nirobase.me/sitemap-index.xml의도는 단순했다. 메인 페이지와 post 들만 크롤링하길 원했고 나머지는 굳이 안건드렸으면 했다. 그런데 이 나머지에 sitemap 이 포함될 줄은 몰랐다.
robots.txt 의 해석
URL 에 매칭되는 규칙 중 가장 긴 규칙 한가지를 적용한다. 규칙이 적힌 순서는 상관이 없다. ’$’ 로 끝나는 URL 은 끝을 의미한다.
| 경로 | 매칭되는 규칙 | 결과 |
|---|---|---|
/ | Allow: /$ | 허용 |
/posts/... | Allow: /posts/ | 허용 |
/sitemap-0.xml | Disallow: / 뿐 | 차단 |
/_astro/... (CSS/JS/이미지) | Disallow: / 뿐 | 차단 |
/about/, /archive/, /2/ … | Disallow: / 뿐 | 차단 |
Sitemap: 으로 사이트맵 위치를 알려주는 것과, 그 파일을 크롤링해도 되는지는 별개의 문제다.
주소는 알려줘놓고 정작 들어오지는 못하게 막아둔 셈이다. 다만, 좀 이상한 것은 robots.txt 에 따르면 sitemap-index.xml 도 결과가 성공으로 나오면 안되었는데 이게 성공으로 나온점은 아직도 이해가 가지 않는다.
NOTE사이트맵에 ‘성공’ 이 떠 있던 건 아마 마지막으로 읽었을 때의 결과가 남아있던 것 같다. GSC 의 사이트맵 상태는 실시간이 아니다.
덤으로 /_astro/ 가 막혀 있다는 것도 알게 됐다. Astro 는 빌드된 CSS, JS, 최적화된 이미지를 전부 /_astro/ 에 넣는다.
여기가 막혀 있으면 Googlebot 은 포스트를 스타일도 스크립트도 없는 상태로 렌더링하게 되고, 본문 이미지도 색인되지 않는다.
수정
기존 구조(포스트만 허용)는 유지하고, 사이트맵과 /_astro/ 만 추가로 열어줬다.
User-agent: *Disallow: /Allow: /$Allow: /posts/Allow: /sitemap-Allow: /_astro/
Sitemap: https://nirobase.me/sitemap-index.xmlAllow: /sitemap- 로 적은 이유는 포스트가 늘어서 sitemap-1.xml 이 생겨도 따로 신경쓰지 않기 위해서다.
TIP딱히 숨길 페이지가 없다면
Disallow: /대신Allow: /하나로 전부 여는 게 제일 속 편하다. 특정 페이지를 검색에서 빼고 싶다면 robots.txt 로 막기보다 해당 페이지에<meta name="robots" content="noindex">를 넣는 게 맞다. robots.txt 로 막으면 Google 은 그 페이지의 noindex 조차 읽지 못한다.
Astro 에서 robots.txt 수정
Astro 에서는 public/robots.txt 로 정적 파일을 두거나, src/pages/robots.txt.ts 엔드포인트로 생성한다. 필자는 후자였다.
import type { APIRoute } from "astro";
const robotsTxt = `User-agent: *Disallow: /Allow: /$Allow: /posts/Allow: /sitemap-Allow: /_astro/
Sitemap: ${new URL("sitemap-index.xml", import.meta.env.SITE).href}`.trim();
export const GET: APIRoute = () => new Response(robotsTxt, { headers: { "Content-Type": "text/plain; charset=utf-8" }, });Cloudflare 캐시 비우기
필자 같은 경우 블로그 앞단에 Cloudflare 가 있어서, 배포를 해도 robots.txt 는 한동안 캐시된 옛날 버전이 나간다. (cache-control: max-age=14400, 4시간)
전체 캐시를 날릴 필요는 없고 해당 URL 만 비우면 됐다.
Caching → Configuration → Purge Cache → Custom Purge → URL 에서 https://nirobase.me/robots.txt 입력 후 적용.
GSC 에 다시 알려주기
Google 도 robots.txt 를 최대 24시간 정도 캐시한다. 서버에서 고쳤다고 바로 반영되지 않는다. 아래의 적용 방법을 적용해도 아마 바로 성공으로 안뜰 수도 있고 아직도 차단됨이라고 나올 수도 있다. 마음속으로 잘했을꺼라 믿음을 가지며 기다림의 시간을 가지는 방법밖엔 없다.
- 설정 → 크롤링 → robots.txt → 보고서 열기
https://nirobase.me/robots.txt우측⋮→ 다시 크롤링 요청- 확인된 시간이 갱신되고, 가져온 내용에
Allow: /sitemap-가 보이면 OK - Sitemaps 에서 사이트맵 재제출
NOTE다만 robots.txt 보고서에 새 버전이 반영된 후에도 URL 검사의 실시간 테스트는 한동안
robots.txt에 의해 차단됨이 뜰 수 있다. URL 검사는 robots.txt 캐시를 따로 쓰는 것으로 보인다. 이 단계부터는 기다리는 수밖에 없다.
정리
- GSC 사이트맵 상태 ‘성공’ 을 믿지 말자. 발견된 페이지가 0 이면 뭔가 잘못된 거다.
- URL 검사의 실시간 테스트로 사이트맵 파일 자체를 검사해보면 원인이 바로 나온다.
- robots.txt 에서
Disallow: /로 시작하는 화이트리스트 방식을 쓴다면 사이트맵 파일과 정적 리소스 경로도 반드시 열어줘야 한다. - 고친 뒤엔 CDN 캐시 → GSC robots.txt 재크롤링 → 사이트맵 재제출 순서로. 결국 GSC 문제가 아니라 내 robots.txt 문제였다.
robots 등을 잘 설정했는지 파악해보기 위해 아래와 같은 사이트를 사용해볼 수도 있다. https://crawlercheck.com/
이 글이 도움이 되었다면 더 많은 분들께 공유해 주세요!
일부 정보가 오래되었을 수 있습니다